Objectifs du monitoring GNSS
Surveiller un réseau GNSS ne consiste pas uniquement à vérifier qu’un processus répond au ping. Une station peut être connectée au serveur mais ne plus produire de messages. Un rover peut recevoir des octets tout en restant en solution Float. Un point de montage peut être visible mais alimenté par des coordonnées incorrectes. Le monitoring doit donc réunir la santé informatique, l’activité du protocole et les informations GNSS disponibles.
Le premier objectif est la détection rapide. L’âge du dernier paquet permet d’identifier une source silencieuse, même si le socket est encore ouvert. Le second est l’explication : la raison d’un refus, le nom du point de montage, le User-Agent et l’adresse distante donnent un contexte. Le troisième est la mesure dans le temps, avec la disponibilité, le nombre de sessions, les durées d’interruption et les tendances du mode RTK.
Le monitoring sert aussi à communiquer. Une équipe support peut confirmer qu’un rover s’est connecté à telle heure, qu’il envoie un GGA et qu’il utilise une station située à une certaine distance. Cette information réduit les échanges imprécis et permet de concentrer le diagnostic sur la réception satellitaire, la configuration du matériel ou la connectivité.
Comment vérifier qu’une station GNSS fonctionne correctement ?
Une station est considérée comme opérationnelle lorsque cinq contrôles sont satisfaits : elle est connectée au bon point de montage, elle envoie régulièrement des données, son débit reste cohérent, ses coordonnées RTCM correspondent à la station déclarée et aucune autre source n’utilise le même point de montage. Le simple état « connectée » ne suffit pas.
1. Vérifier le point de montage et la session
Le centre de contrôle affiche le nom du point de montage, l’heure de connexion et l’adresse distante de la source. Ces informations répondent à une première question : est-ce bien la station attendue qui alimente ce flux ? Si une deuxième source tente d’utiliser le même point de montage, le serveur la refuse afin d’éviter que deux stations différentes envoient des corrections sous le même nom.
2. Vérifier la date de la dernière donnée reçue
Une connexion TCP peut rester ouverte alors que le récepteur n’envoie plus rien. Il faut donc regarder le temps écoulé depuis le dernier paquet RTCM. Pour une station qui émet chaque seconde, une absence de données pendant cinq secondes signale probablement une coupure. Le délai d’alerte doit toutefois être adapté à la fréquence réelle de la station.
3. Comparer le débit à son niveau habituel
Le volume reçu par minute permet de détecter un flux vide ou fortement réduit. Il ne faut pas comparer aveuglément deux stations : le débit dépend du nombre de constellations, du type de messages RTCM, de leur fréquence et du nombre de satellites visibles. La bonne méthode consiste à comparer chaque station à son propre débit habituel.
4. Contrôler les coordonnées envoyées dans le RTCM
Les messages RTCM 1005 et 1006 contiennent l’identifiant et les coordonnées de la station. Le serveur les convertit en latitude, longitude et hauteur afin de les comparer aux coordonnées enregistrées dans la fiche du point de montage. Une différence importante peut révéler une mauvaise configuration, un changement de station ou un flux associé au mauvais nom.
Le message 1006 contient en plus une hauteur d’antenne. Cette valeur doit être interprétée séparément de la hauteur géographique de la station. Les messages 1007, 1008 ou 1033 peuvent aussi fournir des informations sur l’antenne et le récepteur, lorsqu’ils sont présents dans le flux.
5. Gérer l’alerte et le retour à la normale
Pour une station déclarée permanente, le serveur ouvre un incident lorsque l’absence de données dépasse le délai configuré. Il envoie une seule alerte avec le point de montage, l’heure et la dernière activité connue. Lorsque les données reviennent, il ferme l’incident et indique sa durée. Une station temporaire peut être surveillée avec une règle différente afin d’éviter les alertes inutiles lorsqu’elle est volontairement arrêtée.
| Contrôle | État normal | Anomalie | Action recommandée |
|---|---|---|---|
| Session source | Un seul flux sur le point de montage attendu | Source absente ou tentative en double | Vérifier le nom du point, le mot de passe et l’équipement connecté |
| Dernière donnée RTCM | Mise à jour conforme à l’intervalle configuré | Le compteur continue d’augmenter sans nouvelle donnée | Contrôler le récepteur, le modem et la liaison Internet |
| Volume reçu | Proche du niveau habituel de cette station | Débit nul ou baisse durable et inhabituelle | Vérifier les messages RTCM et les constellations configurées |
| Coordonnées 1005/1006 | Cohérentes avec la fiche du point de montage | Position absente ou nettement différente | Contrôler les coordonnées de référence et l’association du flux |
| Station permanente | Aucun incident ouvert | Délai sans données dépassé | Alerter une fois, suivre la durée puis notifier le rétablissement |
Monitoring des rovers et du mode RTK
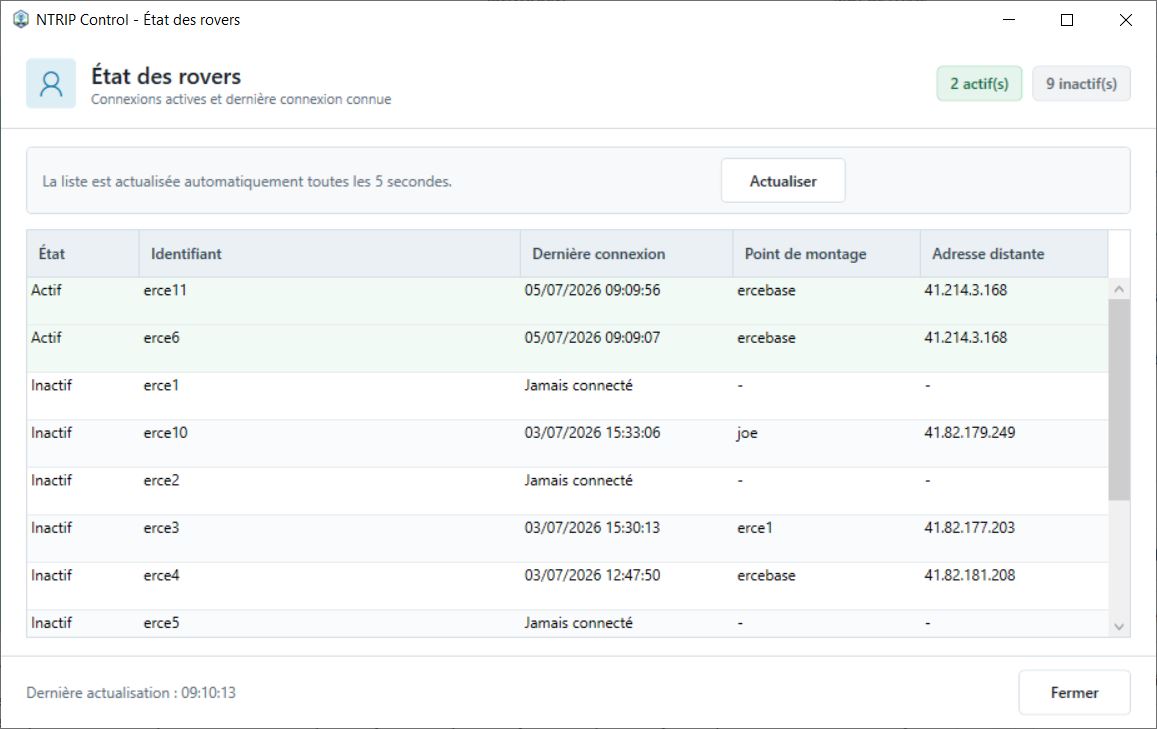
Le rover est identifié par son compte NTRIP, pas par son adresse MAC. À travers Internet, le serveur connaît l’adresse IP publique et éventuellement le User-Agent, mais ces valeurs peuvent être partagées ou modifiées. Un compte par matériel ou par opérateur demeure la base la plus simple pour suivre les usages et révoquer un accès.
La phrase GGA envoyée par le client apporte la position. Le champ de qualité peut être traduit en états opérationnels : Single lorsque la position est autonome, Float pour une solution différentielle non fixée, Fix pour une solution RTK fixée. D’autres valeurs NMEA existent, et le logiciel doit conserver la valeur brute si elle ne correspond pas à une catégorie connue.
La fréquence GGA dépend du client. Certains envoient une phrase toutes les secondes, d’autres toutes les cinq ou dix secondes. Exiger une première GGA avant d’envoyer le RTCM est utile pour un service dépendant de la position, mais peut rendre incompatibles des rovers qui n’envoient pas de GGA. Le paramètre doit donc être activable par tenant ou par service.
La distance entre le rover et sa station est calculée à partir des coordonnées géographiques. Elle fournit un indicateur simple de ligne de base. Une limite peut être appliquée à certaines stations pour protéger une zone commerciale ou maintenir une qualité attendue. Il faut cependant prévoir les incertitudes de la position déclarée et expliquer clairement la raison d’un rejet.
Alertes automatiques et gestion des incidents
Une alerte efficace doit être actionnable. Le message contient le tenant, la station ou le rover, l’heure UTC, la condition observée, la dernière activité et un lien ou une indication de contrôle. Une phrase générique comme « serveur en erreur » oblige le destinataire à recommencer le diagnostic. Une alerte trop détaillée, remplie de pile d’appels, est au contraire difficile à lire sur un téléphone.
Les canaux peuvent inclure le centre de contrôle, l’e-mail et WhatsApp. Chaque canal a ses contraintes de débit et d’authentification. L’échec d’un serveur SMTP ne doit pas arrêter le caster. Il doit être journalisé, puis retenté selon une politique bornée. Les secrets SMTP et les jetons de messagerie restent dans la configuration serveur ou dans des variables d’environnement protégées.
La temporisation évite les faux positifs pendant une brève reconnexion mobile. Une station critique peut nécessiter une alerte après quelques secondes ; une station temporaire ne doit peut-être pas être surveillée hors de ses heures d’utilisation. Le modèle de source permanente permet de distinguer ces cas. Les fenêtres de maintenance planifiées peuvent aussi suspendre les notifications sans masquer les événements.
Un incident possède un début, des mises à jour et une fin. Conserver cette structure permet de calculer le temps moyen de rétablissement et la disponibilité. Une succession de microcoupures peut révéler un modem instable, même si la disponibilité globale semble correcte. Les statistiques doivent donc inclure le nombre d’interruptions en plus de leur durée totale.
Historique, statistiques et conservation
Les événements WebSocket sont éphémères : un logiciel fermé ne les reçoit pas. Le serveur conserve donc un historique des connexions, positions et raisons de fin de session. À l’ouverture, le centre de contrôle demande la période souhaitée, dessine les points historiques puis passe au temps réel. Cette séquence garantit une carte utile dès la connexion.
La rétention doit être explicite. Pour le suivi opérationnel des rovers, vingt-quatre heures offrent un compromis raisonnable entre contexte et volume. Cinquante clients envoyant un point toutes les cinq secondes représentent 864 000 positions par jour ; la taille dépend fortement du format d’enregistrement et des index. Un stockage compact et une purge périodique sont indispensables.
Les événements récents conservés en mémoire doivent être bornés par MaxRecentEvents ou un mécanisme équivalent. Une collection circulaire supprime les plus anciennes entrées. L’historique durable peut être écrit dans une base ou un fichier structuré avec rotation. Lire un fichier entier à chaque requête ne convient pas lorsque le volume augmente.
Les statistiques utiles comprennent disponibilité par station, nombre de rovers uniques, durée moyenne de session, répartition Fix/Float, points de montage les plus utilisés, refus par raison et volumes transférés. Ces indicateurs servent à dimensionner le service et à améliorer l’assistance, mais ils doivent être filtrés par tenant et protégés comme des données d’exploitation.
| Indicateur | Source | Utilité |
|---|---|---|
| Âge du dernier RTCM | Boucle de lecture source | Détecter une station silencieuse |
| Mode Fix/Float/Single | NMEA GGA du rover | Suivre la qualité opérationnelle |
| Distance base-rover | Positions source et client | Contrôler une ligne de base |
| Durée d’incident | Événements de coupure et retour | Mesurer la disponibilité |
| Volume transmis | Compteurs de sockets | Dimensionner le réseau |
Méthode de diagnostic
Le diagnostic commence par la chaîne la plus courte. Vérifier que le service écoute, que le port est ouvert et que le domaine résout la bonne adresse. Contrôler ensuite l’arrivée de la source, son point de montage et l’âge du dernier paquet. Puis examiner l’authentification du rover, la réponse ICY ou HTTP et les premières écritures RTCM. Enfin, confirmer la réception GGA et le mode RTK.
Un Broken pipe pendant l’écriture signifie que le client a fermé ou perdu la connexion. L’erreur doit être traitée comme une fin de session, sans journal Fail répétitif ni ObjectDisposedException secondaire. La boucle de lecture du client peut être arrêtée par le même jeton d’annulation afin que les deux directions se terminent proprement.
Une négociation TLS reçue sur le port NTRIP en clair se reconnaît aux premiers octets binaires. Le serveur doit éviter de les afficher comme une ligne illisible et expliquer que le client utilise HTTPS sur un port HTTP. À l’inverse, une erreur de certificat sur un port TLS se traite au niveau de la terminaison ou du certificat du domaine.
Lorsqu’un rover reste en Float, le monitoring réseau ne suffit pas. Il faut contrôler la fraîcheur du RTCM, les messages et constellations diffusés, la distance, la visibilité du ciel, l’antenne, la hauteur, le repère et la configuration du moteur. Le centre de contrôle réduit le domaine de recherche en prouvant ce qui a effectivement traversé le serveur.
Confidentialité, capacité et qualité des données
La position d’un rover est collectée pour exploiter le service de corrections : sélectionner une solution adaptée, contrôler une distance, assister l’utilisateur et comprendre un incident. Cette finalité doit être communiquée aux entreprises et aux opérateurs. Les données ne sont pas conservées indéfiniment par défaut, et les exports restent soumis aux droits du tenant.
La qualité des données historiques dépend de leur origine. Une GGA peut être arrondie, répétée ou remplacée par une position configurée. Le monitoring conserve l’heure de réception, l’identifiant de session et la raison de l’événement afin de ne pas présenter la trajectoire comme une mesure scientifique certifiée. Une position absente ne doit pas être inventée à partir de l’adresse IP.
Le dimensionnement combine fréquence des GGA, nombre de clients, durée de rétention et taille des index. Le stockage peut agréger les points anciens ou limiter leur précision selon l’usage, mais il doit conserver suffisamment de détail pour le diagnostic. Les requêtes paginées et les limites empêchent un seul centre de contrôle de charger toute la base.
Les données de monitoring sont sauvegardées selon leur importance, puis purgées par une tâche contrôlée. Les métriques agrégées peuvent être conservées plus longtemps que les positions individuelles. Cette séparation fournit des tendances de disponibilité sans transformer le service en archive permanente des déplacements.
FAQ du monitoring GNSS
Quelle fréquence de surveillance faut-il utiliser ?
La fréquence dépend du risque opérationnel. Les connexions et interruptions doivent être détectées en quelques secondes, tandis que les synthèses de disponibilité, de volume ou de dérive peuvent être calculées sur des périodes plus longues.
Une position RTCM 1005 ou 1006 est-elle une position mesurée en continu ?
Non. Ces messages décrivent les coordonnées de référence de la station dans le repère ECEF. Elles servent à identifier la position annoncée par le flux, mais elles ne constituent pas à elles seules une analyse complète de stabilité géodésique.
Comment distinguer Fix, Float et Single ?
Le mode peut être déduit du champ qualité de la phrase NMEA GGA envoyée par le rover. Fix indique généralement une solution d’ambiguïtés entières, Float une solution différentielle non fixée et Single une position autonome ou non corrigée.
Quelles alertes sont prioritaires ?
La perte d’une station permanente, l’absence prolongée de données RTCM, une succession d’échecs d’authentification, une distance excessive et une dégradation durable du mode RTK sont des événements prioritaires.